
24.08.2022
Von Peter Hecker, Inhaber von HECKER CONSULTINGTeil 1 der Serie überträgt DAX auf Mengen- und SQL-Konzepte und zeigt die Grundoperation CROSSJOIN in den Funktionen CROSSJOIN und SUMMARIZECOLUMNS.
Der erste Artikel dieser Serie führt in die Thematik ein, DAX auf andere Konzepte zu übertragen („Projektion“). Damit sind Mengen-Konzepte, aber auch SQL und Objekt-orientierte Konzepte gemeint.
Der Sinn ist es, hiermit die grundsätzlichen und komplexen Verhaltensweisen von DAX aus der Sicht eines anderen Konzepts transparent zu machen.
Auf einem SQLPASS Event zur Einführung von Power BI und DAX hörte ich vom vortragenden MVP einen Hinweis, dass MDX als Sprache für den Cube von den Anwendern als so schwierig eingestuft wird, dass Microsoft sich entschlossen habe, MDX mit DAX zu ersetzen. In meiner Wahrnehmung ist allerdings DAX nicht unbedingt "einfacher" als MDX, auch nach langjähriger Beschäftigung mit DAX würde ich eher das Gegenteil behaupten.
Tatsache ist: es gibt eine große Anfangshürde bei MDX, die man kaum im Selbststudium überwindet. Hat man diese Hürde aber überwunden, ist die Sprache äußerst plausibel und effektiv anzuwenden. Dagegen scheint DAX schon bei den ersten Versuchen leichter verständlich, aber die Schwierigkeiten werden nach und nach sichtbar. Am Schluss scheint es, als ob man auch bei DAX schwer im Selbststudium zum Ziel kommt.
Gerade BI-Spezialisten erscheint die Sprache DAX inkonsequent, intransparent und es ist gerade für diese professionelle Zielgruppe nicht klar ersichtlich, auf welchen grundlegenden Konzepten DAX beruht. Die Sprache scheint eher aus einem großen Haufen von Regeln zu bestehen und es ist schwierig, die Funktionalität von einem Punkt aus zu betrachten.
Die Erfahrung beim Unterrichten zeigt, dass das Thema DAX im Unterricht schleifenartig vermittelt werden muss, so, wie es auch das Handbuch "The Definitive Guide To DAX" macht. D.h. man kommt immer wieder zu den gleichen Themen zurück, aber bei jeder Runde wird der Stoff weiter vertieft. Dies erweckt bei den Teilnehmern gern den Eindruck, dem Dozenten fehle für den DAX-Stoff ein geeigneter roter Faden "vom Leichten zum Schweren"
Die typische Zielgruppe der PowerUser wie z.B. Finanz-Analysten ist primär an schnellen Ergebnissen interessiert, nicht an den Grundlagen der Sprache. Tatsächlich genügen dieser Zielgruppe häufig einfache Erklärungen, ein Tag Einführung oder YouTube-Videos für die Erstellung einfacher KPIs. Wenn es bei den einfachen Fällen bleibt oder wenn das Layout der Berichte, für die diese KPIs erstellt wurden, nicht verändert wird, sind schnell erworbene Grundlagenkenntnisse tatsächlich der effektive Weg, um schnell KPIs zu entwickeln. Für diese Zielgruppe ist es sinnvoll, nicht den Overhead der Sprach-Grundlagen zu erlernen, um am Schluss nur einfache Fälle zu lösen.
Die Schwierigkeiten beginnen dort, wo die Umstände sich ändern:
Es existieren zwei Annahmen, die durch meine eigenen Erfahrungen mehr als deutlich widerlegt wurden:
Aus meiner jetzigen Perspektive gibt es keine einfachen DAX-Expressions bzw. einfachen DAX-Abfragen. Auch eine einfache DAX-Query muss vollständig in ihrer ganzen Komplexität verstanden sein, damit KPIs unter allen Umständen das erwartete Ergebnis zeigen. Die Funktion "CALCULATE" verbirgt - mehr oder weniger - das ganze Konzept der Sprache DAX. Oder anders ausgedrückt: wer "CALCULATE" verstanden hat, kann DAX-Code entwickeln.
Meine Serie soll dabei helfen, die Grundlagen der Sprache zu verstehen. Dabei greife ich auf verschiedene andere Konzepte zurück, um DAX verständlich zu machen („Projektion“):
Bei den Mengen-Konzepten handelt es sich dabei genau um die Konzepte, auf denen die Sprache MDX beruht und die Microsoft dem Anwender offensichtlich ersparen möchte. Vermutlich aus diesem Grund werden Sie in der Dokumentation auf Microsoft Learn keine Hinweise darauf finden.
Wenn man sich vor Augen hält, dass MDX und DAX im tabularen Modell auf dem gleichen Backend, der VertiPaq-Engine, arbeiten, so ist klar, dass die Parallelen zu Mengen-Konzepten nicht nur theoretischer Art sind: MDX mit seinen Sets, Tupels und Membern ist quasi die native Sprache für den Cube, sei es in der multidimensionalen oder in der tabularen Ausprägung. DAX dagegen wird von tabularen Modellen nativ verarbeitet.
Die Serie richtet sich an Anwender, die bereits die ersten Erfahrungen in DAX gesammelt haben und mit den Konzepten "Filter", "Context Transition" und "Filter Propagation" (s. Marco Russo) etwas anfangen können. Vorteilhaft sind darüber hinaus auch fundierte Kenntnisse in SQL und / oder einer Objekt-orientierten Sprache wie z.B. C#. Leser, die Konzepte aus anderen Bereichen als DAX nicht kennen, können die jeweiligen Abschnitte auch überspringen.
Der Gedanke des CROSSJOINs besteht darin, jedes Element von Menge 1 mit jedem Element aus Menge 2 zu verknüpfen. Das Beispiel zeigt den CROSSJOIN für zwei 1-dimensionale Sets – ein Entwickler würde sagen „Arrays“ – mit Elementen aus verschiedenen Dimensionen. set1 enthält Buchstaben, set2 enthält Zahlen. Das Ergebnis der Verknüpfung ist ein 2-dimensionales Tupelset. Ein Set wird hier syntaktisch mit „{}“ dargestellt und ein Tupel mit „()“.
set1 = { A, B }
set2 = { 1, 2, 3 }
set3 = set1 CROSSJOIN set2
Inhalt von set3: { (A, 1 ), (A, 2), (A, 3), (B, 1), (B, 2), (B, 3) }

Die CROSSJOIN-Funktion verhält sich wie in der Theorie erwartet, sie bildet das vollständige kartesische Produkt aus Region und City.
Die Syntax von SUMMARIZECOLUMNS lautet:
SUMMARIZECOLUMNS (
- <groupBy_columnName> [, < groupBy_columnName >]…,
- [<filterTable>]…
- [, <name>, <expression>]…)
Nur der erste Argument-Typ ist verpflichtend: Es müssen eine oder mehrere Gruppierungsspalten angegeben werden. Das nächste Beispiel zeigt den Einsatz von SUMMARIZECOLUMNS mit den entsprechenden Beispiel-Daten von oben. Es wird nur der erste verpflichtende Argument-Typ verwendet.

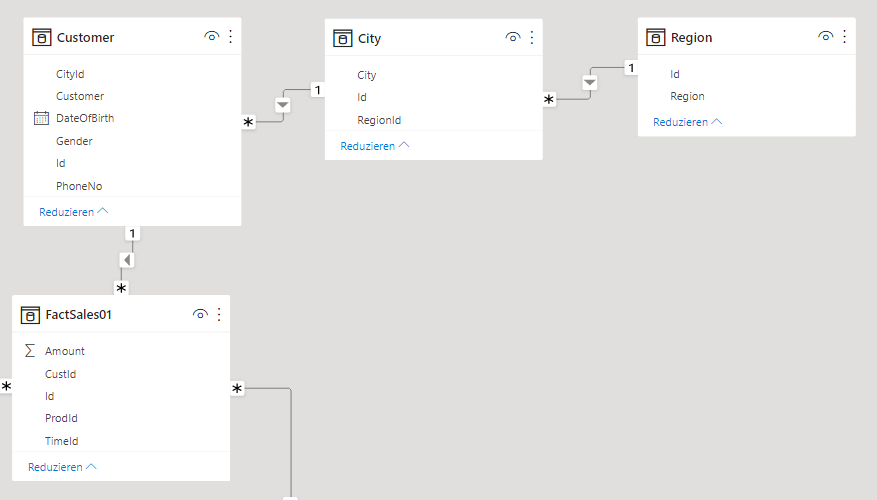
Das Beispiel belegt, dass die Hauptoperation von SUMMARIZECOLUMNS tatsächlich ein CROSSJOIN über die Gruppierungsspalten ist. Im Beispiel ist das Datenmodell hinter der DAX-Abfrage ein Snowflake-Schema. Die Entitäten „City“ und „Region“ sind dabei in separaten Tabellen abgelegt und über Beziehungen verbunden:

Das nächste Beispiel zeigt wieder eine Abfrage mit SUMMARIZECOLUMNS und den gleichen Daten. Jedoch sind die Entitäten Region und City in denormalisierter Form bereitgestellt. Das Modell ist ein Star-Schema.

Die DAX-Abfrage führt jetzt zu einem anderen Ergebnis:

Es wurde jetzt nicht mehr die vollständige Kreuz-Matrix gebildet; „Berlin“ beispielsweise tritt nur noch zusammen mit der Region „North“ auf.
Bei CROSSJOIN wird – unabhängig vom Datenmodell – die vollständige Kreuz-Matrix gebildet
Bei SUMMARIZECOLUMNS wird optional die vollständige Kreuz-Matrix über Tabellen eingeschränkt, in der sich die Spalten befinden
Die beiden nachfolgenden Beispiele zeigen die Set-Operationen, wie man sie sich in SQL vorstellen kann.
Die Spalten-Werte stammen aus zwei verschiedenen Tabellen:

Beachten Sie folgenden Unterschied zum vorausgegangenen Beispiel: Die Werte für „Region“ und „City“ stammen jetzt beide aus derselben Tabelle, nämlich "dimPerson1". Nachdem die vollständige Kreuzmatrix gebildet wurde, wird die Tabelle „dimPerson1“ benutzt, um nur die Tupel zurückzugeben, die auch tatsächlich existieren.

Die allgemeine Erkenntnis aus dem zweiten Beispiel ist, dass Tabellen eine Liste gültiger Tupel vorgeben, die zum Filtern anderer Sets verwendet werden können.

Wir erweitern ständig unser Beratungsportfolio. Über 600 Beratungsleistungen haben wir für Sie im Programm. Selbstverständlich lassen sich die einzelnen Themen kombinieren. So erhalten Sie genau die Beratung, die Sie wünschen und brauchen.
Mehr IT-, Online-, Digital-Beratungsleistungen anzeigen >>Sie gestalten Power BI Dashboards und Berichtsseiten, die eine Frage auf einen Blick beantworten – mit passenden Diagrammen, klarer Anordnung, Drillthrough und Lesezeichen, mobiler Ansicht, Warnungen und Abonnements.
Sie lernen Power BI als Ganzes kennen – vom Datenimport in Power BI Desktop über Bericht und Dashboard bis zur App im Arbeitsbereich – und wissen danach, welche Lizenz Sie für welchen Schritt brauchen.
Nach dem Einstieg in Power BI Desktop binden Sie Excel-Listen, Datenbanken, Webseiten und SharePoint an, bereiten die Daten im Power-Query-Editor auf, kombinieren Tabellen zu einem Modell und veröffentlichen das Ergebnis für Ihr Team.
Sie erzeugen mit Copilot in Power BI Berichtsseiten, Visuals und Zusammenfassungen, schreiben und erklären DAX-Abfragen, dokumentieren semantische Modelle und klären vorab Kapazität, Mandanteneinstellungen und Datenschutz.
Datenmodellierung in Excel: Sie bereiten Daten mit Power Query für das Modell auf, bauen ein Sternschema mit Beziehungen und Hierarchien und rechnen mit Power Pivot und DAX-Measures Kennzahlen, die bei jeder Aktualisierung stimmen.
Sie nutzen ChatGPT als Helfer neben Power BI Desktop: DAX-Measures und Power-Query-Schritte entwerfen und erklären lassen, Datenmodelle planen, Berichtsseiten skizzieren – und dabei keine vertraulichen Daten preisgeben.
Mit SSAS Tabular in Microsoft SQL Server bauen Sie ein zentrales Datenmodell mit Beziehungen, DAX-Measures und Zeitintelligenz, sichern es auf Zeilenebene ab, stellen es bereit und vergleichen es mit semantischen Modellen in Power BI.
In der Power BI Praxis entwickeln Sie einen Bericht durchgängig selbst: Rohdaten im Abfrage-Editor aufbereiten, Kennzahlen mit DAX von CALCULATE bis zur Zeitintelligenz berechnen, Seiten gestalten und das Ergebnis sicher veröffentlichen.
Zeilen- und Filterkontext, Kontextübergang, CALCULATE und CALCULATETABLE: Mit diesem Verständnis schreiben Sie Measures, Zeitvergleiche, Mengenausdrücke und DAX-Abfragen für Power BI, Analysis Services und Power Pivot – und können jedes Ergebnis begründen.
Sie lesen und schreiben Power Query M sicher – vom Typsystem über List-, Record- und Table-Funktionen bis zu eigenen Funktionen, Fehlerbehandlung und Query Folding in Excel, Power BI und Dataflows.
Programmierer:innen verstehen Power Query M als funktionale Sprache mit verzögerter Auswertung, lösen typische Datenaufgaben in Code und binden Web-APIs mit Paging, Folding und eigenen Konnektoren an.
Welche Auswertung bleibt in Excel, welche wandert nach Power BI? Sie wägen das fundiert ab, nutzen Power Query, Datenmodell und DAX in beiden Werkzeugen und bauen aus einer vorhandenen Excel-Auswertung Ihre erste Power-BI-Lösung.
Sie verstehen, was Ihre bestehenden Power BI Dataflows leisten und woran sie hängen, und planen den Umstieg auf Dataflow Gen2 in Microsoft Fabric – mit Datenzielen, Zeitplänen und einem Blick auf die Kapazitätskosten.
Sie bauen in Power BI Berichte für das Marketing- und Vertriebscontrolling, die von Reichweite und Leads über Pipeline und Umsatz bis zu NPS und Weiterempfehlung die ganze Kundenbeziehung abbilden – und teilen sie mit den Teams, die damit steuern.
Aktuelle und interessante Themen und Beiträge für Sie zusammengetragen und aufbereitet.
In der heutigen datengetriebenen Geschäftswelt ist die Fähigkeit, aus komplexen Datenmengen schnell wertvolle Erkenntnisse zu gewinnen, ein entscheidender Wettbewerbsvorteil. Microsoft Power BI Desktop bietet als leistungsstarkes Business Intelligence-Tool die perfekte Plattform für Datenanalyse und -visualisierung - auch für Einsteiger. Erfahren Sie in diesem Artikel, wie Sie verschiedene Datenquellen einbinden, Daten professionell transformieren und ansprechende interaktive Dashboards erstellen, die Ihre Entscheidungsfindung revolutionieren werden.
Die Details der Interaktion zwischen äußerer und innerer Funktion sind nicht Teil der Power-Query-Dokumentation auf Microsoft Learn und es liegt an Ihnen als Power Query Entwickler, sich eine Vorstellung davon zu machen, was diese unsichtbare Interaktion jeweils sein könnte. Teil 2 dieser Serie beschäftigt sich mit der Frage, wie äußere Power Query Funktion und Lambda Expression miteinander interagieren.
In Teil 1 dieser Serie über Lambda Expression wird gezeigt, wie Lambda Expressions innerhalb von Power Query Iteratoren arbeiten. Grundsätzlich ist nahezu jede Power Query Funktion ein Iterator. Durch das Platzieren von Lambda Expressions innerhalb von Power Query Funktionen, werden daher die Lambda Funktionen wiederholt aufgerufen. Bei jedem Aufruf werden dabei andere Daten an die Lambda Expression übergeben.
